OpenRouter: qué es, cómo funciona y por qué me costó 11 € al mes frente a Claude Code
OpenRouter explicado: qué es, cómo usar una sola API key para todos los modelos, cuánto me costó frente a Claude Code y qué privacidad vigilar.
OpenRouter: qué es, cómo funciona y por qué me costó 11 € al mes frente a Claude Code
Descubrí OpenRouter por casualidad, configurando Hermes agent, y acabó cambiando cómo pago y uso los modelos de lenguaje. Es un servicio que da acceso a cientos de modelos de distintos proveedores con una sola API key, una sola API y una sola factura. En este artículo documento qué es, qué ventajas tiene en la práctica, cómo lo integré y cuánto gasté usándolo con el mismo volumen de trabajo que en Claude Code: 11 € en un mes. También explico dónde hay que tener cuidado con la privacidad, que es el punto que más se pasa por alto.
Contenido
Qué es OpenRouter y cómo lo descubrí al configurar Hermes
Qué ventajas tiene OpenRouter frente a una API key por proveedor
Cómo llamar a cualquier modelo con la API de OpenRouter
Cómo elegir el mejor modelo para cada tarea con OpenRouter
Cómo ver el gasto exacto de tokens en el log de OpenRouter
Por qué OpenRouter me salió más barato que una suscripción a Claude Code
Qué proveedores hay detrás de cada modelo y qué riesgos de privacidad tiene OpenRouter
Qué es OpenRouter y cómo lo descubrí al configurar Hermes
Todo empezó al instalar Hermes. En el asistente de configuración, el primer paso era elegir mi proveedor de modelos. La lista incluía los nombres que ya conocía (OpenAI, Anthropic, Google), pero entre ellos había uno que no había visto nunca: OpenRouter. Podía haber elegido el proveedor de siempre y seguir adelante. Pero soy de los que no pulsan "siguiente" sin saber qué están eligiendo, así que paré y me puse a leer.
La pregunta inicial era simple: ¿qué es esto y por qué aparece al mismo nivel que los grandes laboratorios? La respuesta corta es que OpenRouter no entrena modelos propios. Es una capa intermedia, un router o pasarela. Tú le envías una petición indicando qué modelo quieres, y él la enruta al proveedor que lo sirve: Anthropic, OpenAI, Google, Z.ai (GLM), o alguno de los muchos proveedores de modelos abiertos. Te cobra el consumo desde un único saldo de créditos prepago.
El logotipo morado que aparece en su web da bastante igual, pero la idea detrás sí importa. Es el equivalente a un agregador: en vez de abrir una cuenta en cada proveedor, abres una sola.
Qué ventajas tiene OpenRouter frente a una API key por proveedor
Antes de OpenRouter, mi situación era la habitual. Tenía una key de OpenAI, otra de Anthropic, otra de GLM. Cada una con su panel, su facturación, su saldo mínimo y su manera de limitar el gasto. Cada vez que quería probar un modelo nuevo, otra cuenta, otra tarjeta y otro token que guardar en un .env.
Con OpenRouter esto cambia en tres puntos concretos:
Un solo token para todos los proveedores. Una key da acceso a todo el catálogo. No tengo que gestionar un secreto por laboratorio.
Keys separadas por aplicación. Aquí está la ventaja de arquitectura que más valoro. Puedo crear una key distinta para Hermes, otra para un script de resumen, otra para un experimento. Cada una puede tener su propio límite de crédito. Si una se filtra o se descontrola un bucle, el daño queda acotado y, además, en el log sé qué aplicación generó cada gasto.
Una sola facturación. Recargo créditos en un sitio y veo todo el consumo junto. Ojo con un detalle: al comprar créditos OpenRouter aplica una comisión (cuando lo revisé rondaba el 5,5 %). Conviene mirarlo antes de recargar, porque forma parte del coste real.
Dividir el acceso por aplicación es una práctica que ya aplicaría con cualquier servicio externo (principio de mínimo privilegio), y aquí viene hecha de serie.
Cómo llamar a cualquier modelo con la API de OpenRouter
La segunda cosa que me convenció fue la API. Es compatible con el formato de OpenAI, así que solo hay que programar una llamada y el modelo pasa a ser un parámetro. Cambiar de Claude a GPT o a GLM es cambiar una cadena de texto, no reescribir el cliente.
Este es el patrón mínimo con el SDK de OpenAI en Python:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)

resp = client.chat.completions.create(
    model="anthropic/claude-sonnet-4.5",  # cambia esto y listo
    messages=[{"role": "user", "content": "Resume este diff en 5 líneas"}],
)
print(resp.choices[0].message.content)
Para usar otro modelo, sustituyo anthropic/claude-sonnet-4.5 por openai/gpt-4o-mini o por el identificador de cualquier otro del catálogo. El resto del código, el manejo de errores y el parseo de la respuesta no cambian. Para un sistema con varios agentes o tareas con distinta complejidad, esto simplifica mucho la arquitectura: el modelo se convierte en configuración, no en dependencia de código.
El mismo base_url sirve en cualquier herramienta que acepte un endpoint compatible con OpenAI, que es justo lo que hace Hermes por debajo cuando eliges OpenRouter como proveedor.
Cómo elegir el mejor modelo para cada tarea con OpenRouter
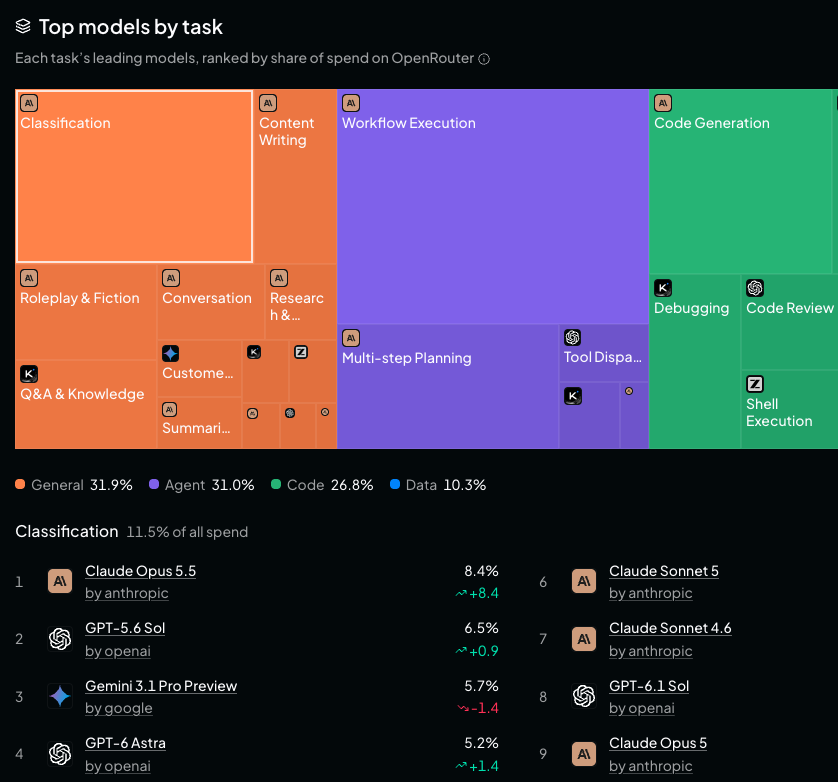
Tener todos los modelos a un parámetro de distancia plantea un problema nuevo: ¿cuál uso para qué? OpenRouter ayuda a decidir con datos del propio catálogo, donde se pueden comparar modelos por precio, contexto y rendimiento.
En una de las pantallas que más he consultado aparece un mapa titulado Top models by task. Divide el uso en categorías: General (31,9 %), Agent (31,0 %), Code (26,8 %) y Data (10,3 %). Dentro de cada una hay tareas concretas: Classification, Content Writing, Workflow Execution, Multi-step Planning, Code Generation, Debugging, Code Review, Shell Execution… Y para cada tarea, el ranking de modelos líderes. En Classification, que supone el 11,5 % del gasto total, lideraba Claude Opus 5.5 con un 8,4 %, seguido de GPT-5.6 Sol (6,5 %) y Gemini 3.1 Pro Preview (5,7 %).
Una advertencia de rigor: ese ranking, como indica el propio subtítulo, está ordenado por cuota de gasto, no por calidad medida. Es una señal de qué eligen miles de desarrolladores en la práctica, y eso es útil, pero no sustituye a un benchmark ni a tu propia prueba. Mi método es este:
Miro qué modelos se usan más para mi tipo de tarea.
Los contrasto con benchmarks públicos.
Los pruebo con mis prompts reales y comparo resultado y coste.
Así he llegado a una distribución razonable: un modelo barato y rápido para tareas mecánicas, uno de gama alta para razonamiento y código complejo.
Cómo ver el gasto exacto de tokens en el log de OpenRouter
Aquí es donde OpenRouter me ganó definitivamente. En la pestaña Generations hay un registro de cada petición con fecha, modelo, tokens de entrada, tokens de salida y coste exacto. Se acabó adivinar cuánto me ha costado una sesión.
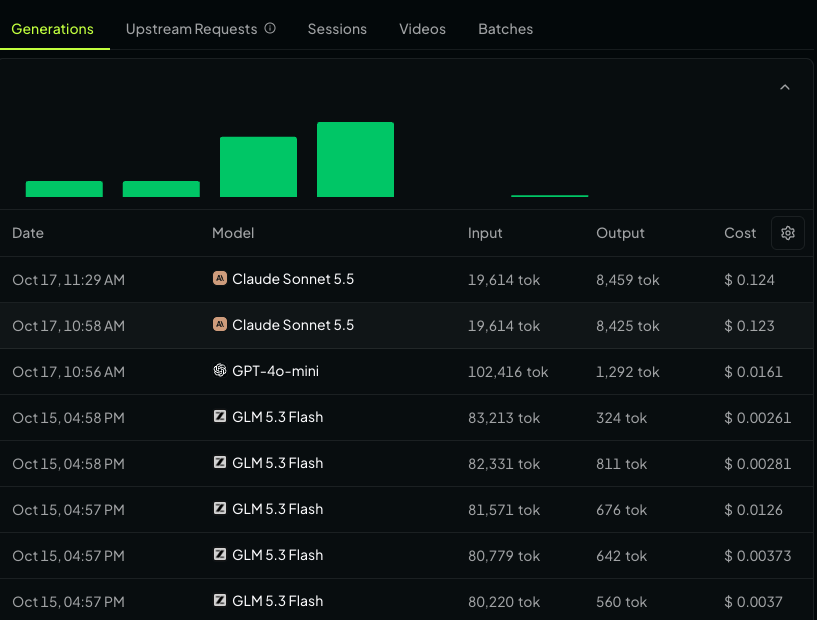
En mi captura se ve bien. Dos peticiones a Claude Sonnet 5.5 el 17 de octubre, de unos 19.600 tokens de entrada y unos 8.400 de salida, costaron 0,124 $ y 0,123 $. Justo debajo, una petición a GPT-4o-mini con 102.416 tokens de entrada y apenas 1.292 de salida costó 0,0161 $. Es una lección práctica: un contexto cinco veces mayor costó casi ocho veces menos porque el precio por token del modelo mini es mucho más bajo.
Más abajo, el 15 de octubre, hay una ráfaga de llamadas a GLM 5.3 Flash con entre 80.000 y 83.000 tokens de entrada cada una, a costes de fracciones de céntimo: 0,00261 $, 0,00281 $, 0,00373 $, 0,0037 $. Esto es típico de un agente que reenvía un contexto largo en cada paso.
Pero hay una fila que me llamó la atención: una llamada a GLM 5.3 Flash con 81.571 tokens de entrada y 676 de salida costó 0,0126 $, unas cuatro o cinco veces más que sus vecinas, con tokens casi idénticos. Mi hipótesis es que cambió el proveedor upstream o que no hubo acierto de caché en esa petición. Para eso existe la pestaña Upstream Requests, que permite ver qué proveedor atendió cada llamada. Es el tipo de anomalía que con una suscripción plana jamás verías, y con este log puedes detectarla y corregirla fijando proveedor.
El gráfico de barras de la parte superior también me sirve: muestra de un vistazo los días de actividad intensa y los días en que prácticamente no toqué nada.
Por qué OpenRouter me salió más barato que una suscripción a Claude Code
Esta es la parte que más me preguntan. He usado OpenRouter de forma intensiva, con el mismo volumen y complejidad de tareas que hacía con Claude Code, y en un mes gasté 11 €.
Mi razonamiento de por qué sale más barato es este:
Pago por uso frente a cuota fija. Claude Code se paga religiosamente cada mes. Si me voy dos semanas de vacaciones, mi uso real baja a casi cero pero la suscripción es la misma. Con créditos prepago, esas dos semanas me cuestan 0 €.
No trabajo con IA 12 horas al día, siete días a la semana. A menos que programar con un agente sea tu trabajo principal y lo uses de forma continua, hay días sin uso, fines de semana y semanas flojas. La suscripción te cobra por la capacidad, no por lo que consumes.
Mezcla de modelos. No todo necesita un modelo de gama alta. Las tareas mecánicas las resuelvo con modelos baratos, como se ve en el log, y reservo los caros para lo que realmente lo requiere.
Quiero ser honesto con el límite de esta conclusión. Si mi uso fuese el de alguien que trabaja con el agente a tiempo completo, doce horas o más al día, todos los días, mi estimación es que acabaría gastando más o menos lo mismo que con Claude Code, porque el coste por token se acumularía hasta igualar la cuota. La suscripción compensa a quien la exprime al máximo. Mi caso, un uso intenso pero irregular, es donde el pago por uso gana con claridad.
Mi recomendación para decidir es simple: recarga una cantidad pequeña, usa OpenRouter un mes con tu flujo real y mira el total en el log. Tendrás tu cifra, no la de otro.
Qué proveedores hay detrás de cada modelo y qué riesgos de privacidad tiene OpenRouter
Un mismo modelo puede estar servido por varios proveedores. Esto es especialmente visible con los modelos abiertos, que pueden alojar distintas empresas con precios, latencias y cuantizaciones diferentes. OpenRouter elige por defecto según precio y disponibilidad, y puede hacer fallback a otro si uno falla. Es una ventaja de resiliencia, y probablemente la explicación de variaciones de coste como la que vi en el log.
Pero esto trae el punto en el que quiero insistir: tienes que mirar qué hace cada proveedor con tus datos. Al enviar un prompt, esos datos viajan a un tercero que quizá no es el laboratorio que esperabas. Debes comprobar, para cada proveedor que uses:
Si almacena tus prompts y respuestas, y durante cuánto tiempo.
Si los usa para entrenar sus modelos.
En qué jurisdicción opera.
Si trabajas con código de clientes, credenciales, datos personales o propiedad intelectual, esto no es un detalle. Las herramientas que yo reviso:
Ajustes de privacidad de la cuenta, donde puedes excluir los proveedores que registran o entrenan con tus datos.
Preferencias de enrutamiento por petición. Por ejemplo, con el cliente anterior:
resp = client.chat.completions.create(
    model="openai/gpt-4o-mini",
    messages=[{"role": "user", "content": "..."}],
    extra_body={"provider": {"data_collection": "deny"}},
)
Con data_collection: "deny" se descartan los proveedores que pueden almacenar o usar los datos. La documentación también contempla opciones más estrictas, como limitar a proveedores con retención cero. Revisa la documentación vigente porque estos parámetros evolucionan.
Mi regla personal: lo sensible solo va por rutas con proveedores verificados y política restrictiva, y lo demás va por la opción barata. Que un modelo sea muy barato suele significar que alguien, en algún punto, está sacando valor de otra parte, y conviene saber de dónde.
Hoy OpenRouter es mi capa por defecto para trabajar con modelos. Una key por aplicación, una API estándar, un log que me dice cuánto me cuesta cada llamada y una factura mensual que en mi caso fue de 11 € en lugar de una cuota fija. Si lo pruebas, empieza con poco saldo, crea una key por proyecto, revisa la privacidad antes de la primera petición y contrasta tu gasto real durante un mes antes de cancelar nada.